當視覺語言模型走向邊緣端,AI 終於真正具備實戰營運能力

大多數關於 AI 的討論仍圍繞在準確度、參數或模型大小。但對於工業與基礎設施團隊而言,真正的問題其實更簡單:
AI 能否在不依賴雲端的情況下,在現場足夠快速地做出決策?
這正是視覺語言模型(VLM)從根本上改變邊緣 AI(Edge AI)價值的地方——並非透過增加更多智慧,而是讓智慧在實際營運中變得切實可用。
單靠視覺已然不足
電腦視覺已被廣泛應用於製造、物流和智慧基礎設施中。攝影機可以檢測瑕疵、識別物體並觸發警報。然而,大多數系統仍受限於一個眾所周知的瓶頸:
它們「看」得到了,卻無法「理解」上下文情境。
傳統的視覺系統或許能檢測出異常模式,但它無法:
- 解釋該異常為何重要
- 將其所見與操作流程進行連結
- 以自然語言回應人類的提問
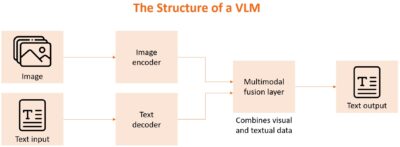
視覺語言模型(VLM)透過將視覺感知與基於語言的推理相結合,填補了這一鴻溝。它們不再只是輸出標籤或分數,而是生成「意義」——在機器感知與人類意圖之間架起橋樑。
為什麼雲端不適合工業環境下的 VLM
VLM 通常讓人聯想到龐大的雲端 AI 模型。但在現實世界的工業場景中,雲端帶來的往往是阻礙而非價值。
常見的限制包括:
- 延遲會耽誤關乎安全至關重要的決策
- 持續串流影片所產生的頻寬成本
- 數據主權與隱私疑慮
- 連線不穩定時的營運風險
對於外觀檢測、情境感知或現場診斷等應用而言,等待雲端回應絕非可行之選。
這就是為什麼當 VLM 部署在邊緣端時,能發揮遠大於以往的影響力。
邊緣 AI 將 VLM 轉化為可執行的情報
在邊緣 AI 平台上運行 VLM,將 AI 從單純的「分析」推向了「執行」。
在邊緣端,VLM 能夠:
- 在本地端即時解讀視覺場景
- 回應操作員提出的自然語言查詢
- 將視覺輸入與操作規範或手冊進行關聯對照
- 在不依賴雲端的情況下,觸發即時應對行動
團隊不再只是詢問:「攝影機偵測到了什麼?」,而是可以進一步提問:
- 「這台機器目前是否在安全限制內運作?」
- 「與正常營運狀態相比,有哪些地方改變了?」
- 「告訴我風險在哪裡,以及原因為何。」
這將 AI 從單純的「監控工具」轉化為「決策支持系統」。
邊緣端 VLM 發揮關鍵作用的實際營運場景
在實際部署中,基於邊緣端的 VLM 其價值將變得顯而易見:
製造與自動化
- 外觀檢測系統不僅能標記瑕疵,更能解釋瑕疵產生的原因
- 透過情境推理,實現更快速的根本原因分析
- 減少對現場高度專業 AI 工程師的依賴
智慧基礎設施與城市
- 在本地端解讀交通或公共空間中的複雜場景
- 在原始數據不離開現場的情況下,進行保障隱私的影像分析
- 對異常或不安全的情況做出更快速的反應
物流與倉儲
- 將視覺理解與任務級別的指令相結合
- 更具彈性的人機協同合作
- 適應不斷變化的場景佈局與工作流程
I在所有情況下,智慧在「事件發生現場」才能發揮最大的價值。
讓 VLM 在邊緣端切實可用
在雲端之外部署 VLM,不僅僅需要一個強大的模型。它更需要一個專為現實世界各種限制而設計的平台。
關鍵需求包括:
- 在有限的功耗與散熱預算內,優化 AI 效能表現
- 支援 AI 加速器與異質運算
- 為 AI 工作負載提供安全啟動與基於硬體的信任根
- 具備滿足全天候(24/7)運作的工業級可靠性
這正是專為特定用途打造的邊緣 AI 平台,其表現優於通用運算硬體的地方。
從 AI 能力邁向 AI 部署
整個產業正在跨越「AI 能做什麼」的提問階段,邁向思考「AI 應該在哪裡運行」。VLM 代表了 AI 能力的重大躍進,而邊緣 AI 則決定了這項能力能否被安全、可靠且大規模地部署。兩者結合,共同構成了不僅強大、更具實戰營運能力的智慧系統基石。
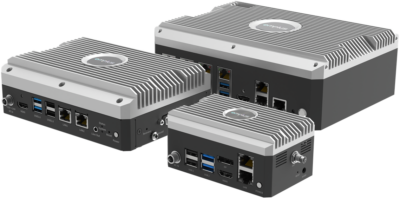
在 Emplus,我們的 Edge AI Box 旨在填補這一鴻溝——將視覺語言智慧直接帶入應用現場。透過在邊緣端實現優化的 AI 推理、即時視覺分析與多模態理解,它能協助企業將 AI 創新轉化為可落地部署的解決方案。因為在工業環境中,智慧只有在現場、即時且毫無妥協地運作時,才具有真正的價值。